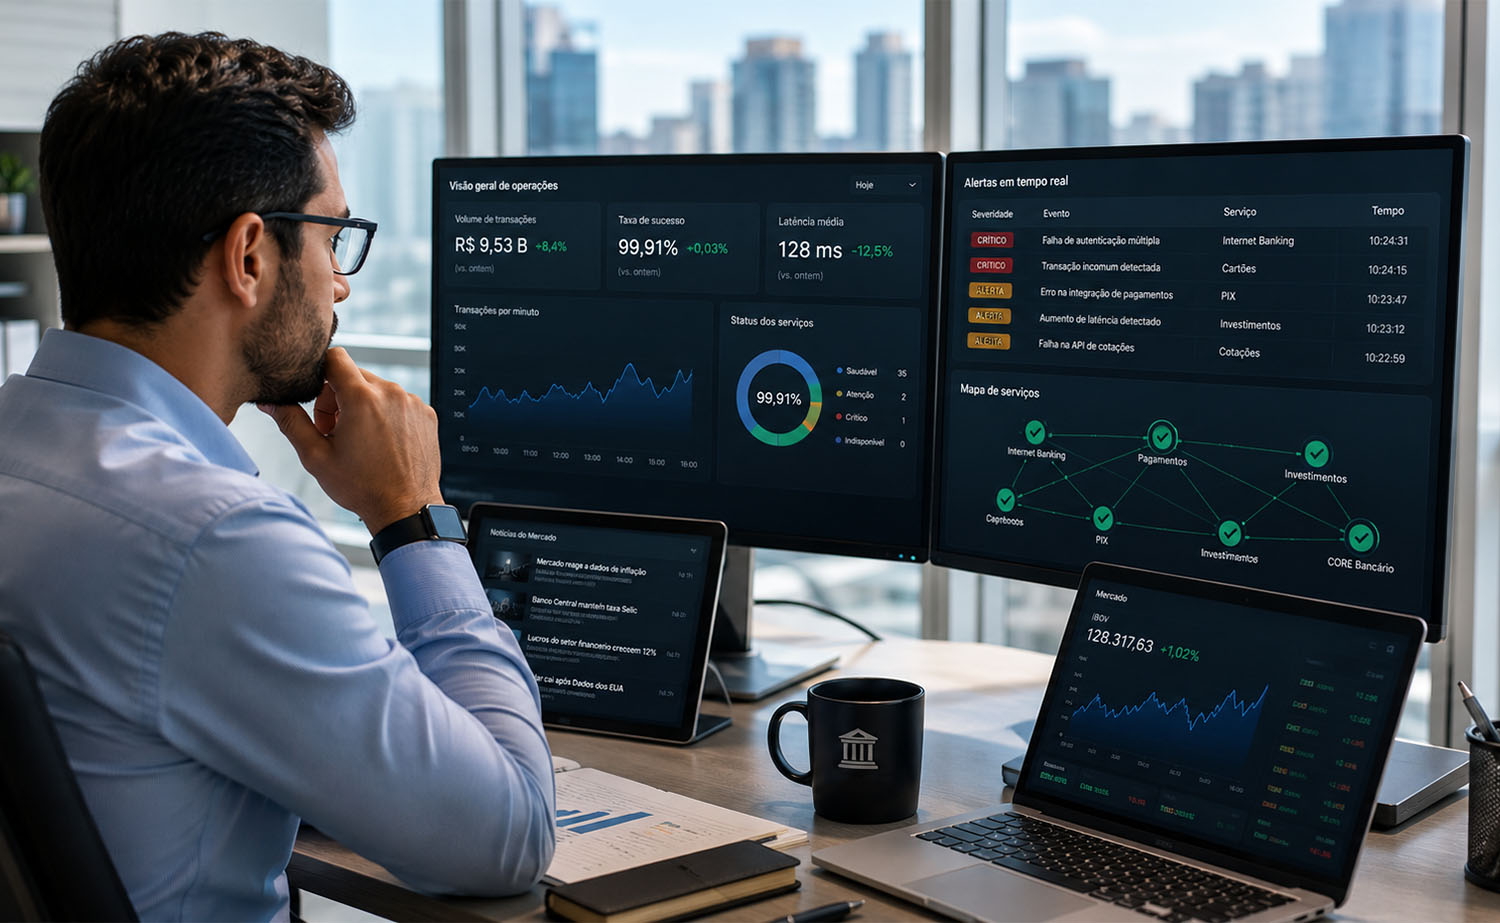
Como a observabilidade fortalece a resiliência das operações financeiras? A observabilidade amplia a visibilidade sobre aplicações, transações, sistemas e infraestruturas, permitindo identificar anomalias e sinais de degradação antes que provoquem interrupções maiores. Com a análise integrada de métricas, logs e rastreamentos, as instituições financeiras conseguem investigar incidentes com mais rapidez, preservar a disponibilidade dos serviços e sustentar operações críticas com mais segurança e eficiência.
A digitalização transformou a disponibilidade tecnológica em uma condição essencial para o funcionamento do setor financeiro. Aplicativos bancários, meios de pagamento, plataformas de investimento e canais de atendimento precisam processar informações continuamente, com desempenho consistente e segurança.
Essa experiência depende de arquiteturas formadas por serviços cloud, APIs, bancos de dados, sistemas legados e fornecedores externos. Quando uma dessas camadas apresenta lentidão ou instabilidade, o impacto pode se propagar por toda a jornada do cliente, mesmo que os componentes individuais continuem aparentemente ativos.
Nesse cenário, a observabilidade no setor financeiro deixa de ser apenas uma prática de suporte técnico e passa a orientar decisões sobre continuidade, risco e experiência digital.
Por que as operações financeiras estão mais complexas?
As operações financeiras modernas são distribuídas entre diferentes aplicações e serviços. Uma única transação pode atravessar mecanismos de autenticação, sistemas antifraude, APIs, bancos de dados, plataformas de pagamento e serviços de terceiros antes de ser concluída.
Essa estrutura aumenta a capacidade de inovação, mas também cria novas dependências. Uma degradação em qualquer etapa pode gerar lentidão, erros intermitentes ou indisponibilidade, enquanto a equipe visualiza apenas alertas isolados e sem contexto suficiente para localizar a origem do problema.
O impacto é relevante. Um estudo da New Relic sobre observabilidade em serviços financeiros e seguros apontou que 48% dos participantes enfrentam interrupções de alto impacto ao menos uma vez por semana. O custo mediano dessas ocorrências chega a US$ 2,2 milhões por hora.
Além da perda financeira direta, falhas recorrentes afetam a confiança dos clientes, consomem o tempo das equipes técnicas e aumentam a exposição operacional. Por isso, compreender o comportamento de toda a cadeia tecnológica tornou-se indispensável para instituições que sustentam serviços críticos.
Leia também: Soluções de Cloud e Data & AI para o setor financeiro
Por que o monitoramento tradicional já não é suficiente?
O monitoramento acompanha indicadores conhecidos e emite alertas quando limites predefinidos são ultrapassados. Essa prática continua essencial, mas costuma responder a perguntas previamente configuradas, como verificar se um servidor está disponível ou se o consumo de processamento excedeu determinado nível. A AWS diferencia monitoramento e observabilidade ao explicar que o primeiro coleta dados sobre a saúde do sistema, enquanto a segunda permite investigar as interações e encontrar causas em ambientes distribuídos.
Em uma arquitetura complexa, um alerta isolado raramente explica o incidente completo. Uma API pode continuar disponível, por exemplo, mas responder lentamente por causa de uma dependência externa. O monitoramento identifica a alteração do indicador; a observabilidade fornece o contexto necessário para compreender por que ela ocorreu e quais serviços foram afetados.
Portanto, as duas práticas são complementares. O monitoramento avisa que algo conhecido saiu do comportamento esperado, enquanto a observabilidade permite formular novas perguntas a partir dos dados gerados pela operação.
Como a observabilidade amplia a visibilidade das operações financeiras?
A observabilidade reúne dados de aplicações, infraestrutura, APIs, bancos de dados e serviços de terceiros para apresentar uma visão integrada da operação. Essa correlação permite acompanhar uma requisição de ponta a ponta e entender como cada dependência contribui para o resultado final.
Se uma transferência demora mais do que o padrão, a equipe consegue verificar se o atraso surgiu na autenticação, na aplicação, no processamento do banco de dados ou na integração com outro serviço. Em vez de analisar cada componente separadamente, os profissionais trabalham com o mesmo contexto operacional.
Essa visibilidade também favorece a gestão de riscos. O Banco Central atualizou os requisitos de segurança para instituições financeiras com medidas relacionadas à rastreabilidade das operações, integração segura de sistemas, controles de acesso e resposta a incidentes. Dados correlacionados e disponíveis para análise fortalecem a capacidade de investigar eventos e demonstrar controle sobre o ambiente.
Quais são os pilares da observabilidade?
A compreensão de sistemas distribuídos depende da combinação de três sinais de telemetria. Separadamente, eles oferecem partes da história; correlacionados, permitem compreender o comportamento técnico e o impacto para o serviço financeiro.
Métricas
As métricas apresentam dados quantitativos sobre a saúde do ambiente, como disponibilidade, latência, volume de requisições, taxa de erros e consumo de recursos. Indicadores relacionados ao negócio também podem acompanhar a quantidade de transações concluídas, interrompidas ou processadas fora do tempo esperado.
Ao analisar tendências e desvios, as equipes identificam sinais de degradação antes de uma indisponibilidade completa. Um crescimento contínuo da latência, por exemplo, pode revelar saturação de recursos ou perda de desempenho em uma dependência.
Logs
Os logs registram eventos ocorridos nas aplicações, sistemas e infraestruturas. Eles revelam erros, mudanças, acessos e outras informações que ajudam a reconstruir o contexto de um incidente, apoiar auditorias e compreender comportamentos anormais.
Entretanto, apenas armazenar grandes volumes de registros não produz observabilidade. Os logs precisam estar estruturados, centralizados e relacionados a outros sinais para que a equipe encontre rapidamente as informações importantes e reduza o ruído operacional.
Rastreamentos distribuídos
Os rastreamentos distribuídos acompanham o percurso de uma requisição entre diferentes serviços. Eles demonstram quanto tempo cada etapa levou, onde ocorreu a lentidão, qual integração interrompeu a jornada e como o problema se propagou pela arquitetura.
No setor financeiro, essa capacidade é especialmente importante para transações que atravessam muitas dependências. Ao relacionar o rastreamento aos logs e às métricas, a equipe deixa de investigar somente o componente afetado e passa a compreender toda a cadeia do incidente.
Como a observabilidade proativa ajuda a antecipar falhas?
A observabilidade proativa utiliza o histórico e o comportamento atual do ambiente para identificar desvios antes que o serviço deixe de funcionar. Aumento gradual da latência, crescimento incomum de erros e mudanças no volume de transações podem indicar que uma operação está se aproximando de um limite crítico.
Com alertas baseados no impacto para o negócio, a equipe prioriza sinais relacionados às operações mais sensíveis. Em vez de reagir a todos os eventos com a mesma urgência, os profissionais concentram esforços nas anomalias que podem comprometer pagamentos, autenticações ou outros serviços essenciais.
Isso não significa prever ou impedir todas as falhas. A principal contribuição é oferecer evidências para reconhecer tendências, investigar situações incomuns e agir antes que uma degradação localizada provoque uma interrupção mais ampla.
Leia também: AWS DevOps Agent: o que muda na resposta a incidentes e na operação cloud
Como a observabilidade acelera a resposta a incidentes?
Sem dados correlacionados, as equipes precisam alternar entre ferramentas, comparar horários e solicitar informações a diferentes áreas. Esse processo prolonga a investigação e faz com que parte do tempo de resposta seja consumida apenas na tentativa de reconstruir o que aconteceu.
A observabilidade centraliza evidências e facilita a análise da causa provável. Com isso, as instituições podem reduzir o tempo médio para detectar um incidente, conhecido como MTTD, e o tempo médio necessário para restaurar ou resolver o serviço, chamado MTTR.
O estudo da New Relic indica um MTTD mediano de 42 minutos e um MTTR de 58 minutos no setor financeiro e de seguros. Organizações que adotam observabilidade full stack apresentam detecção e resolução mais rápidas, reduzindo os riscos financeiros e reputacionais das interrupções.
Uma operação contínua também exige processos de sustentação. Os Serviços Gerenciados de Cloud da Dedalus combinam gerenciamento 24×7, monitoramento e atuação especializada para manter ambientes modernos, escaláveis e controlados.
Qual é a relação entre observabilidade e resiliência operacional?
Observabilidade e resiliência são capacidades complementares. A primeira oferece visibilidade e contexto sobre o comportamento do ambiente. A segunda representa a capacidade de manter ou recuperar operações críticas diante de falhas, mudanças e interrupções.
O whitepaper da AWS sobre resiliência operacional no setor financeiro destaca a importância de manter serviços contínuos por meio de pessoas, processos e tecnologias preparados para se adaptar a mudanças. A AWS também trata a resiliência como uma responsabilidade compartilhada: o provedor oferece infraestrutura e serviços resilientes, enquanto a instituição precisa projetar e operar suas aplicações de acordo com suas necessidades e obrigações.
Nesse modelo, os dados de telemetria apoiam decisões durante incidentes, testes de recuperação e melhorias de arquitetura. Ao conhecer as dependências críticas e o comportamento dos sistemas sob pressão, a instituição consegue planejar respostas mais coordenadas e recuperar os serviços com maior previsibilidade.
O case da Galapagos Capital demonstra como automação, redundância, testes e monitoramento centralizado podem fortalecer a continuidade operacional e a conformidade em um ambiente financeiro crítico na AWS.
Como a disponibilidade influencia a experiência do cliente?
Para o cliente, a qualidade de uma operação financeira é percebida pela disponibilidade, rapidez e consistência. Uma plataforma pode continuar online e, ainda assim, entregar uma experiência insatisfatória se pagamentos demorarem, consultas apresentarem erros ou autenticações falharem de maneira intermitente.
A observabilidade ajuda a relacionar indicadores técnicos à experiência digital. Ao acompanhar latência, erros e jornadas completas, as equipes identificam quais degradações afetam os usuários e priorizam correções de acordo com a relevância para o negócio.
Essa atuação protege mais do que o funcionamento da infraestrutura. Ela preserva a confiança do cliente, reduz o risco de abandono e sustenta a reputação de instituições que dependem da disponibilidade contínua para manter seus serviços.
Como a Dedalus apoia operações financeiras observáveis e resilientes?
A construção de um ambiente observável começa pela compreensão das aplicações críticas, dependências, indicadores e objetivos do negócio. Com experiência em soluções para o setor financeiro, a Dedalus ajuda instituições a estruturar a coleta e a correlação dos dados necessários para acompanhar desempenho, disponibilidade e riscos operacionais.
Nossa atuação inclui monitoramento 24×7, gestão de incidentes, criação de dashboards, análise de causa raiz, automação de alertas e evolução contínua do ambiente. Dessa forma, as equipes obtêm contexto para responder a eventos com rapidez e direcionar melhorias que aumentem a confiabilidade das operações.
O Dedalus Argos amplia essa capacidade ao combinar observabilidade e FinOps. A solução permite acompanhar em tempo real a saúde técnica e financeira da operação cloud, correlacionando desempenho, consumo e custos para apoiar decisões mais precisas.
Ao integrar o Argos aos serviços de Cloud da Dedalus, a instituição conta com uma base contínua de monitoramento, gestão e otimização. A observabilidade deixa de ser apenas uma ferramenta de diagnóstico e passa a sustentar uma estratégia de resiliência, eficiência e evolução operacional.
Com uma operação observável, as instituições financeiras conseguem identificar anomalias mais cedo, acelerar investigações e preservar a disponibilidade dos serviços que sustentam a experiência dos clientes. O resultado é um ambiente mais confiável, preparado para responder a mudanças e manter operações críticas mesmo diante de situações adversas.
Entre em contato com a Dedalus e descubra como tornar sua operação financeira mais observável, confiável e preparada para responder a incidentes.